Una operación de voicebot que solo revisa métricas en el reporte semanal no tiene observabilidad: tiene historia. Para cuando el reporte llega, los clientes que experimentaron el problema ya colgaron o dejaron de contestar.
La diferencia entre detectar una degradación a los cinco minutos de que ocurre o descubrirla tres días después es la diferencia entre un ajuste rápido y un problema que afectó toda una semana de operación.
Qué significa tener observabilidad real en un voicebot
Observabilidad no es sinónimo de monitoreo: el monitoreo registra qué está pasando, la observabilidad permite entender por qué y anticipar qué pasa si no se interviene.
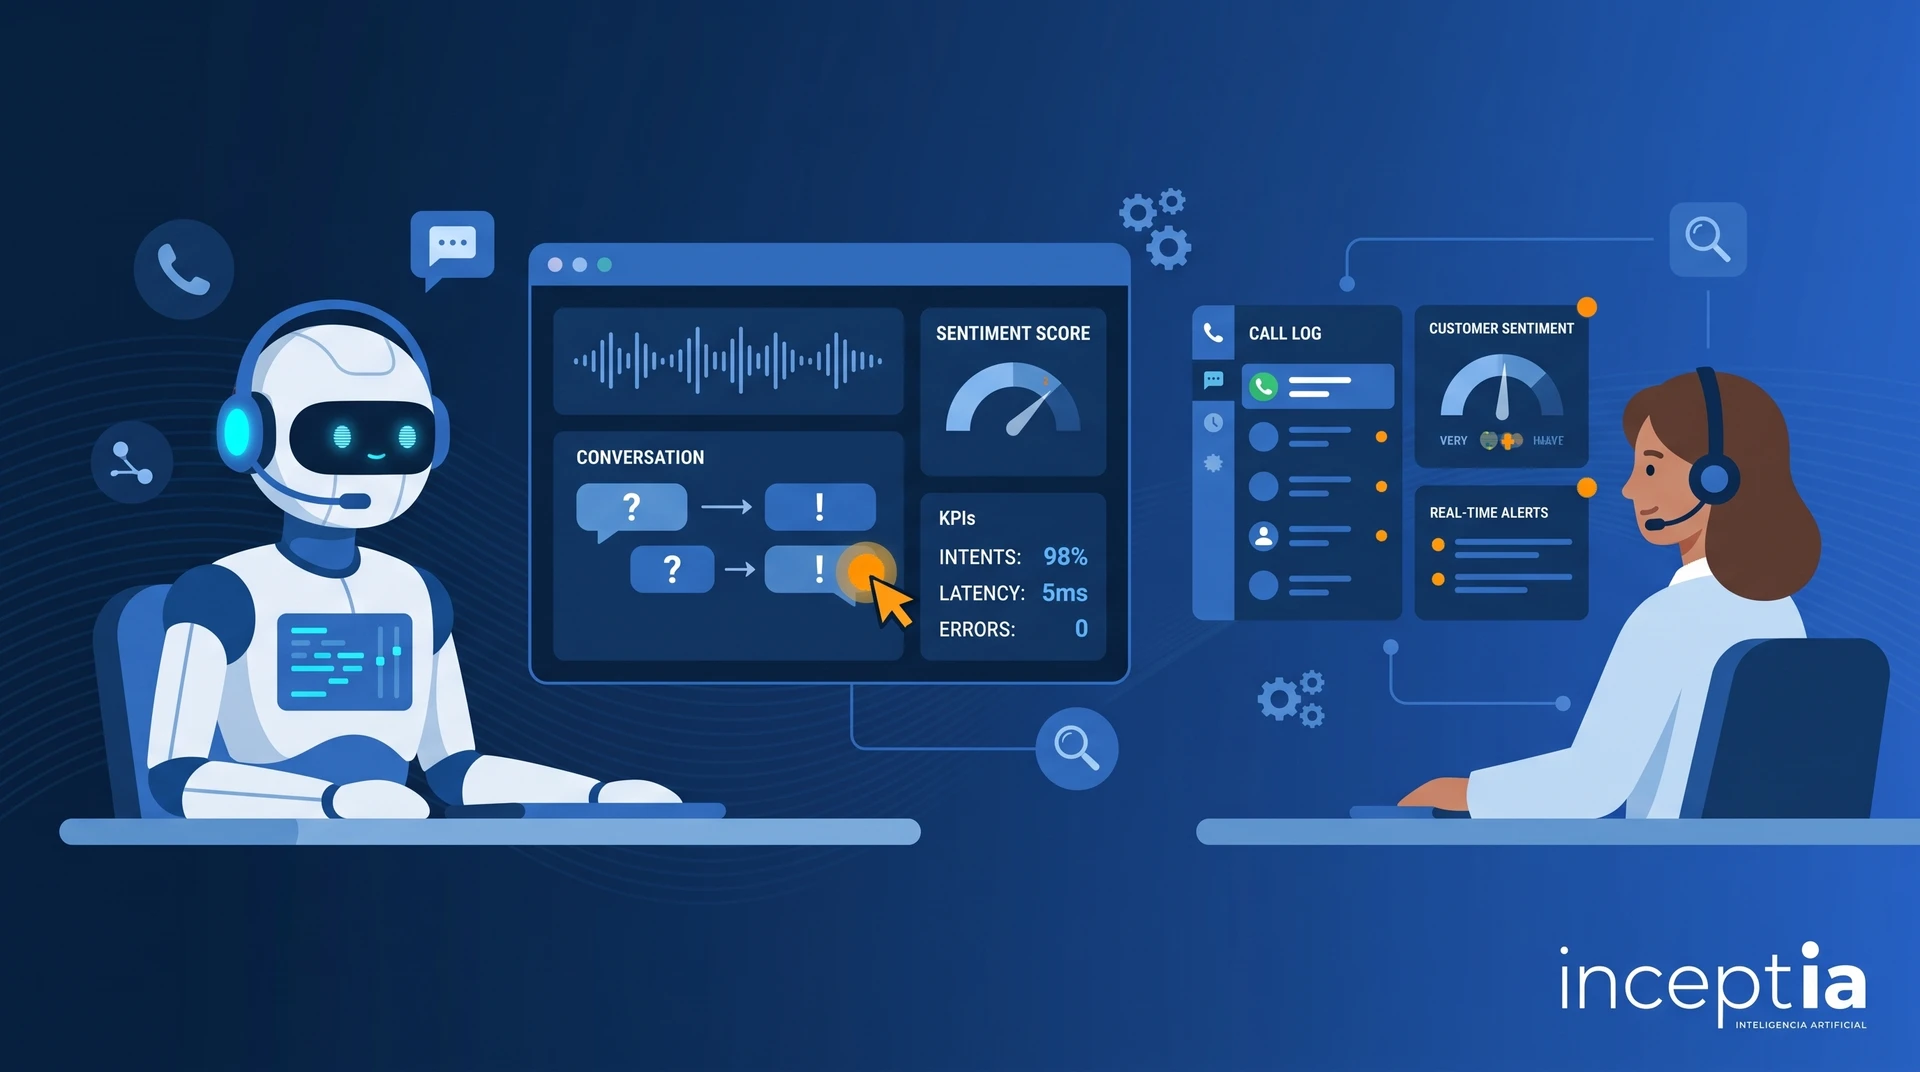
En términos operativos, eso significa acceso a tres capas de información en tiempo real: lo que el sistema hace técnicamente, lo que los clientes experimentan y lo que eso produce en los indicadores de negocio.
Una operación con observabilidad real puede responder en minutos a preguntas que sin ella tardan días, como por qué subió la tasa de escalación o si el problema fue el flujo, la telefonía o el CRM.
Sin esa capacidad, la operación actúa cuando el daño ya es visible. Esta capacidad de ver en tiempo real es complementaria al function calling en voicebots: si el sistema ejecuta acciones sin trazabilidad, detectar un error operativo tarda demasiado.
Las cuatro capas de señales que necesita el dashboard
Un dashboard de observabilidad para voicebots que sirva para tomar decisiones necesita cuatro capas de señales, cada una con una frecuencia de actualización distinta y destinada a una audiencia diferente.
Señales de rendimiento técnico
Revelan si el sistema responde con la velocidad y precisión esperadas. Incluyen el tiempo de respuesta del bot entre turnos, la tasa de fallback (cuántas veces el sistema no pudo clasificar la intención del cliente) y la tasa de errores de integración con el CRM y la telefonía.
Estas señales necesitan actualizarse en tiempo real y activar alertas automáticas cuando superan los umbrales definidos. El mismo tipo de señal aplica en un contact center con IVR: cuando la latencia supera el umbral, el impacto en la conversación ya está ocurriendo.
Señales de calidad conversacional
Revelan cómo está funcionando el flujo desde la perspectiva del cliente. La tasa de abandono por punto del flujo muestra cuándo los clientes están colgando.
La distribución de intenciones detectadas revela si el sistema está clasificando correctamente. La tasa de reintentos indica cuántas veces el cliente tuvo que repetir algo antes de ser entendido.
Señales de resultado operativo
Conectan el comportamiento del bot con los indicadores de negocio. En cobranzas, la promesa de pago por llamada importa más que la contactabilidad cruda. En atención, la resolución en primer contacto vale más que el tiempo de llamada.
Estas señales necesitan actualizarse cada hora durante la operación, porque las decisiones que permiten solo tienen valor si se toman con tiempo suficiente para impactar el resultado del día.
La velocidad con que el sistema refleja lo que pasa define cuánto daño se puede evitar, como también ocurre en el gestor de cobranzas con IA. Solicitá una demo para ver cómo funciona este dashboard con tu operación.
Señales de experiencia del cliente
La satisfacción post-interacción captura lo que ninguna métrica operativa puede inferir sola: si el cliente sintió que fue atendido. Los contactos repetidos por el mismo motivo en 48 horas revelan si la interacción anterior resolvió o solo cerró la llamada.
Alertas que activan acción, no solo notificaciones
El mayor error en el diseño de alertas es configurarlas para informar en lugar de para activar una respuesta. Una alerta que llega cuando el receptor no sabe qué hacer o cuando ya pasaron dos horas no cambia nada.
Las alertas efectivas tienen tres componentes: un umbral definido en función del impacto operativo, un destinatario claro con autoridad para actuar, y un protocolo escrito que define qué hacer cuando se activa.
Ejemplo de protocolo de respuesta por tipo de alerta
| Señal | Umbral de alerta | Protocolo de respuesta |
|---|---|---|
| Tiempo de respuesta del bot | Supera el umbral definido en el SLA durante 5 minutos consecutivos | Verificar latencia de integración con CRM; si persiste, activar escalación humana automática |
| Tasa de fallback | Sube por encima del umbral acordado en el período de medición | Revisar las últimas 20 conversaciones con fallback; identificar intención no cubierta y ajustar el guion |
| Tasa de abandono | Aumenta de forma sostenida durante una hora | Verificar si el aumento se concentra en un punto específico del flujo; si hay correlación, pausar ese segmento |
| Errores de integración con CRM | Supera el umbral durante más de 2 minutos | Verificar disponibilidad del endpoint; si falla, activar modo degradado con datos en caché |
Sin ese protocolo, cada alerta genera una reunión de diagnóstico que tarda más que el problema. Con él, el equipo actúa en minutos.
La misma lógica aplica en la gestión de cobranzas automatizada: la contingencia que no está escrita antes del incidente raramente se ejecuta bien durante él.
Quién necesita ver qué
La observabilidad funciona cuando cada audiencia ve las señales que puede convertir en acción.
- El supervisor en tiempo real necesita señales técnicas y conversacionales por minuto, con alertas visuales cuando algo supera el umbral.
- El equipo de producto necesita las señales de calidad conversacional por turno, actualizadas cada hora, para identificar patrones que requieren ajuste del guion.
- La dirección necesita los indicadores de resultado en vistas diarias y semanales, comparados contra el período anterior y contra el grupo de control si hay un piloto activo.
Plataformas como Inceptia, que integran voicebot omnicanal con telefonía, CRM y trazabilidad completa, permiten instrumentar estas capas sin infraestructura adicional. Solicitá una demo para diseñar el dashboard con tu caso de uso.
Preguntas frecuentes sobre observabilidad en voicebots
¿Cuántas métricas necesita un dashboard de observabilidad para ser útil?
Las necesarias para que cada audiencia tome decisiones. Más de diez indicadores en vista principal suelen generar parálisis. La clave está en la jerarquía: cuáles activan alertas, cuáles son de seguimiento y cuáles son de contexto.
¿Con qué frecuencia deben revisarse manualmente las conversaciones?
Una revisión semanal de una muestra, priorizando fallback alto, abandono y calificación negativa, detecta patrones sistemáticos. La revisión manual complementa las métricas automáticas, no las reemplaza.
¿Qué diferencia hay entre un umbral de alerta y un criterio de nivel de servicio?
El umbral de alerta es el punto donde el sistema notifica que algo se salió del rango esperado. El criterio de nivel de servicio es el compromiso operativo de qué se garantiza. El umbral debería activarse antes de que se incumpla el criterio, para que haya tiempo de actuar antes de que el SLA se rompa.
¿La observabilidad aplica igual en operaciones pequeñas que en operaciones masivas?
La escala cambia la complejidad del dashboard, no la necesidad. Una operación pequeña necesita observabilidad tanto como una masiva, aunque los umbrales y la frecuencia de actualización pueden ser distintos.
¿Cuándo conviene revisar y ajustar los umbrales de alerta?
Después de cada cambio significativo en el flujo o el volumen. Los umbrales definidos al lanzamiento pueden quedar desactualizados a medida que la operación madura. Una revisión trimestral es razonable para operaciones estables.